从模型高分到可靠的个人 AI
从令人惊艳的模型表现,到需要持续评估和维护的实际工作能力
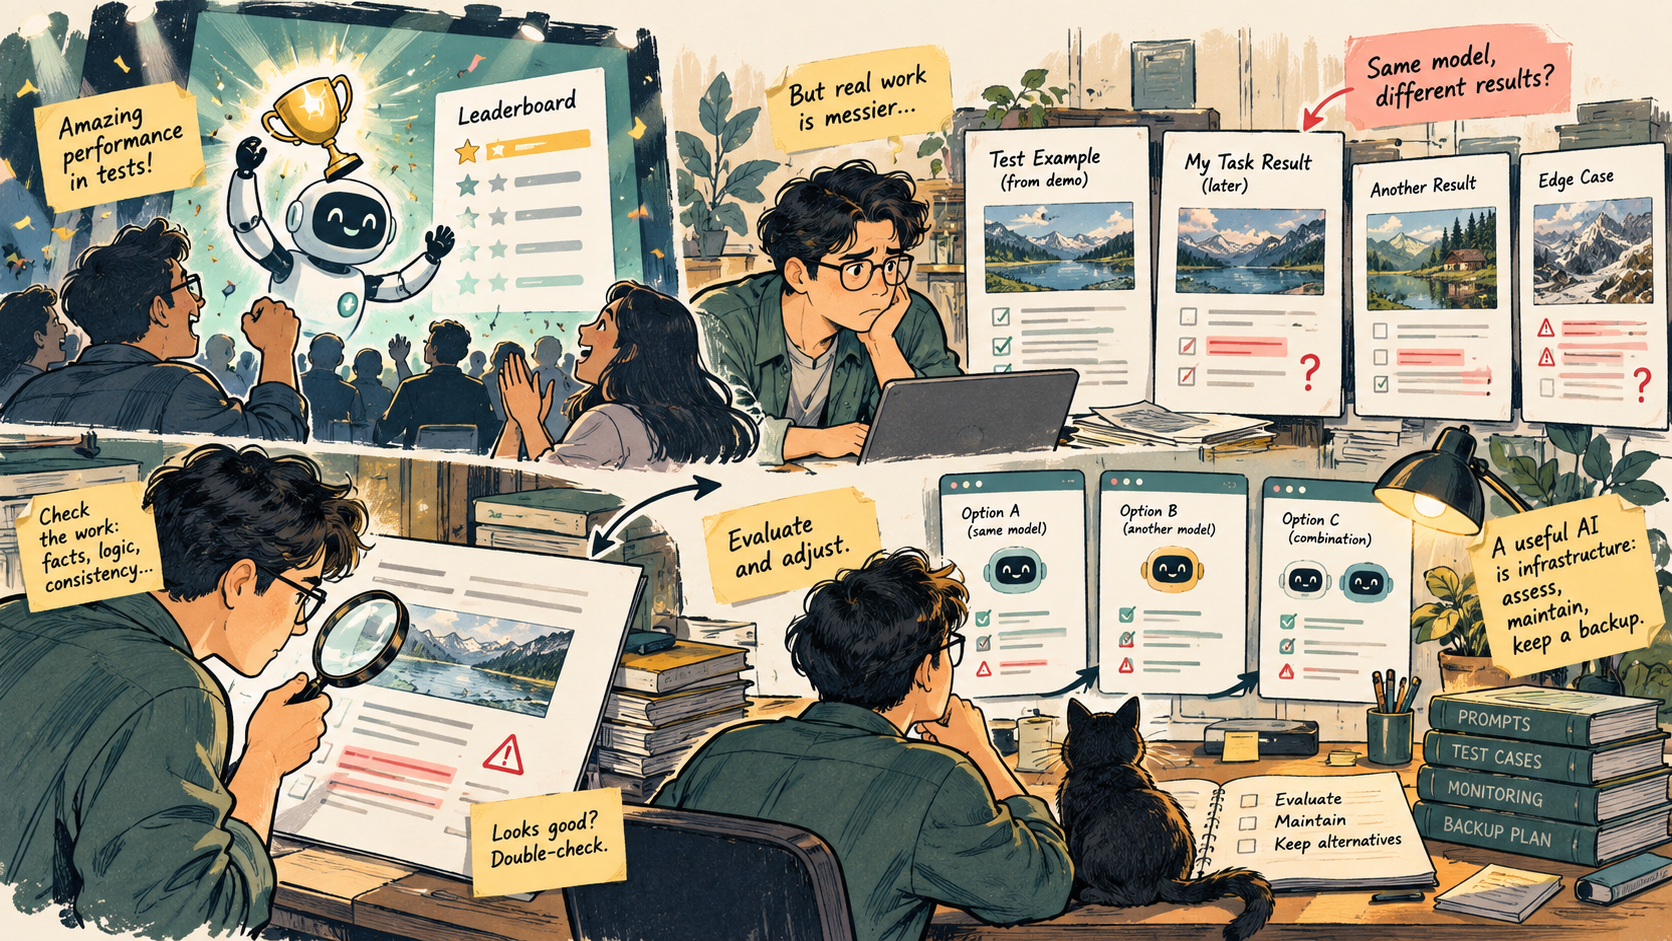
最近使用大语言模型时,我越来越在意一个问题:为什么发布时令人惊艳的模型,用上一段时间后,却未必还能给人同样可靠的感觉?
另一种让我在意的感受是“固执”:使用 GPT-6.1 Sol 时,我有时觉得它过于坚持自己的判断。我想知道,这只是我不适应它的交互风格,还是它接收纠正的方式确实存在问题。目前,这些仍是我的使用感受,还不是控制变量后的结论。
与此同时,模型发布时的高分又提出了另一种疑问:其中有多少代表可以迁移的能力,有多少依赖对热门评测的针对性优化?如果高分不能稳定转化为实际工作成果,个人是否应该考虑保留一套足够好用、可以自行控制的本地模型?
后来,我看到公开的持续评测也在追踪类似变化,相关研究则在讨论高分的可信度和模型对反驳的回应。这让我觉得,值得追问的已经不只是某个模型好不好用,而是:我究竟在依赖什么,又能为长期使用保留多少控制权?
同一个名字不等于同一套能力
我首先想分清两种情况:一段对话越聊越长,后来表现变差;以及把相同任务和上下文放到不同日期,用同一个模型 endpoint 重做,结果发生变化。我更关注后者。上下文管理当然重要,但不能拿它自动解释所有跨日期的退步。
一份让我重新理解这个问题的材料,是 Anthropic 在 2025 年 9 月发布的事故复盘。据公司披露,请求路由错误、运行时优化和编译器问题曾影响部分请求的回答质量,随后通过修复或回滚处理。至少在这起事件中,用户感到的退步被追溯到了后台实现,而不是一句“你没有用好模型”。Anthropic 基础设施复盘
另一个角度来自独立评测者 Margin Lab。其报告记录了使用 Opus 4.7 的 Claude Code 连续数日通过率下降,时间上与 CLI 版本变化对应。报告作者怀疑问题出在代理运行框架,但没有据此确认模型本身退化。由于客户端也在更新,这不是完全冻结环境的实验。不过,它关注的恰好是我在意的对象:实际使用的产品组合,还能否持续完成原来的任务。Margin Lab 持续评测报告
对我来说,失败发生在哪一层都可能意味着返工。区分原因是为了找到处理办法;我不认为必须先证明权重发生变化,才能承认服务表现退步带来的损失。
我也不想只收集支持“越来越差”的材料。Chen 等人比较 GPT-3.5、GPT-4 在 2023 年 3 月与 6 月的 API 版本时,观察到不同任务上的改善与退步并存。这提醒我,需要跟踪的是具体任务上的变化,而不是预先认定所有变化都向下。服务行为变化研究
这些材料让我把观察对象从模型名字,转向模型与运行环境共同交付的能力:推理设置、系统提示、上下文处理、客户端、工具和外部数据,都可能影响结果。即使输入和 endpoint 相同,也不能保证后台版本与运行条件不变。确认表现变化、解释原因和恢复工作,是三个不同的问题;暂时看不清后台发生了什么,不意味着我必须等到查清根因,才能停止无效消耗、寻找替代方案。
高分与真实任务之间的落差
这也让我重新看待发布时的高分。有些落差未必是后来才出现的:模型在测试中表现出色,但我据此期待它能完成的工作,可能从一开始就超出了那些分数能够说明的范围。
测试集污染是一个需要留意的原因。Yang 等人的实验展示了:用改写测试题微调小模型,可以得到很高的相关基准分数,而简单的文本查重可能漏掉这种污染。另一项由 ETH Zurich 团队开展的 ConStat 研究,则比较原基准与相关参考测试的表现,识别没有泛化出去的基准收益。两项研究切入点不同,都让我更关心:离开熟悉的考卷之后,分数代表的能力还剩下多少?但这不是判断某个厂商作弊的凭据;参考测试本身是否合理,也影响这种比较。改写测试题污染研究、ConStat 研究
我的疑问也不限于原题是否泄漏。即使没有直接用测试题训练,围绕热门题型和评分规则反复优化,收益也可能集中在这些条件下。针对数学或编程做专项训练本身没有问题,我更想知道的是:这些收益能否迁移到没有参与训练和选择的新任务?
还有一种更直接的落差:测试本来就在测另一件事。一道边界清晰的编程题,与在已有项目里理解需求、遵守修改范围、处理工具失败和接受反馈,并不是同一种工作。我不需要否定前者的分数,也可以要求后者接受单独检验。
因此,我会把污染、针对评测的过拟合和任务不匹配分开看。它们都值得检查,但也不能拿来替代跨日期变化的调查:即便模型过去针对榜单训练过,也还没有解释同一个任务为什么后来变差。
固执与合理坚持之间的界线
回到我对“固执”的感受,这个词能表达挫败感,却不够精确。我希望模型接受有依据的纠正,但如果我说错了,也希望它能够指出来,而不是马上附和。
一个具体的体会,来自我用 gpt-6.1-sol 协助开发的 DDQN 强化学习项目,目标是让智能体通关《空洞骑士》。此前经过多轮同模型复核,以及与 Astra 的交叉 review,得到的多是实现细节上的修改建议,但训练迟迟没有呈现出我期待的收敛,通关表现也没有起色。
后来,我转向 deepseek-v4.1-flash-1017 做新一轮 review,在 DSH 端完成核心修改的开发与验证,再回到 Codex,用 gpt-6.1-sol 继续调整和复测采样,才看到了训练收敛的改善。
我不会把改善简单归因于换了模型,这一过程中还包含核心修改、后续调整和复测。但这段经历让我意识到,我所说的“固执感”,有时不是模型明确拒绝修改,而是多轮讨论一直停留在同一层次。遇到这种情况,换个视角重新审视核心思路,可能比继续打磨实现细节更值得尝试。
我真正关心的,是证据有没有改变它的后续行为。一个错误判断在获得可核验的纠正后,是否仍被反复维护?模型口头接受反馈后,是否又执行了同样的错误操作?评价重点应当是纠正的有效性,而不是态度是否顺从。
相关研究给了我一个更清楚的区分。Dunlap 等人用两个物理题及构造的回答、反驳,分别考察模型的坚持、迎合和答题能力。Sharma 等人的另一项研究则在多个问答任务中观察到,模型本来答对,却在受到没有新证据的质疑后改成错误答案。这不是对 GPT-6.1 Sol 的测试,但提醒我:“更愿意听我的话”并不能替代纠错能力。对反驳的响应研究、迎合研究
所以,除了第一次能不能答对,我还想检查出错后能不能恢复。如果问题实际出在工具失败、关键上下文丢失或拒绝执行上,也应该分别处理,而不是全部归进“固执”。
个人使用中的四个判断维度
把这些问题放在一起,我倾向于用四个维度判断一个 AI 是否值得长期依赖。这是我整理问题的方式,彼此可以重叠,并不是对发生率的统计分类。
| 维度 | 需要验证的问题 | 不能混为一谈的事 |
|---|---|---|
| 评测有效性 | 榜单表现能否迁移到我的任务? | 高分不等于所有工作都能胜任 |
| 交付稳定性 | 已经验证有效的能力能否持续获得? | 同名模型不等于固定的完整系统 |
| 交互纠错能力 | 错误能否在有效反馈后得到修正? | 接受证据不等于一味服从 |
| 成本与控制权 | 我能否负担使用、控制数据去向并保留退路? | token 单价不等于完成任务的总成本 |
这样比较模型时,我会更在意完成一个合格任务所花的钱、时间和注意力。一次生成便宜,却需要更多轮纠正和人工检查,未必划算;峰值能力很高,却无法持续获得,也未必适合作为唯一依赖。
将可靠性放进工作流
如果把这些判断落实到下一步,我会从自己的任务和工作记录开始:先说明什么算完成,再检查变化,并为失败准备出口。
首先,选出少量真实任务,写下验收条件。写作可以检查翻译是否保留限定条件、修改是否超出范围、引用是否支持结论;编程可以检查功能、回归和无关文件是否被改动。Anthropic 的代理评测指南强调观察最终环境状态;Google 的评测文档也建议用具体使用场景的数据和标准,而不是仅凭公共榜单选模型。我想借用的是这些原则,不是为个人使用搭一座评测平台。代理评测方法、Google 任务评测指南
为了观察跨日期变化,我会固定一部分任务,保存完整输入、资料版本和验收条件,用同一个模型 endpoint 在不同日期重复运行。同时留下不参与提示词调整的新任务,避免把自己的测试集也优化成“熟悉考卷”。记录应同时包含成功、失败和波动,而不是只挑最差或最好的一次。
其次,把测试日期、模型 endpoint 与版本、推理设置、客户端、提示词、工具和任务环境一起记下来。在入口支持时,我会选择明确版本。例如 Gemini 官方区分了具体稳定版本与会随发布切换的 latest 别名。这能减少一类变化,但不保证云服务完整环境永远不变,也不保证旧版本一直可用。Gemini 版本命名说明
升级时,我也更愿意把试用与正式替换分开。先让候选配置在隔离环境里完成同类任务,再决定是否换掉主力,并保留仍可用的旧配置。AWS 的部署指南就包含分阶段验证和回退安排。对个人来说,重要的是保留选择,而不是照搬企业流程;对比也不能让两套代理重复执行真实发布、付款或生产数据修改。模型部署与回退指南
再次,纠正模型时,我希望拿出的是可以检查的依据:代码看测试和运行结果,事实回到原始资料,写作对照事先约定的修改范围。另一个模型可以帮忙复核,但两个模型都赞同,也不等于事情就是真的。
如果结果持续无法验收,补充明确证据后也没有进展,我会停止这一轮循环,先验证其他模型或人工处理能否接手,不等到后台原因查明才行动。独立会话可以帮助排查旧上下文的影响,却不是服务质量回归的通用修复。重试次数和费用也应设限,避免把“坚持完成”变成没有进展的消耗。
最后,交接不能只是把整段聊天转给下一个模型。我会把需求、资料、测试和阶段成果保存在自己控制的文档与版本库里,并分清有证据支持的事实、待验证的假设和已被否定的解释,保留相应来源或否定依据。失败的尝试也值得记录,但一次执行失败,不等于背后的假设已经被证伪。我想避免的是,总结把猜测写成事实,换了模型却继续沿用同一个错误前提。提示词和 skill 可以传递规范,重要边界仍要靠工具权限、检查和人工确认来落实。
本地部署能提供什么
这也是我考虑本地部署的原因。对可本地部署的模型,我可以保留权重、量化版本、运行程序和配置,并决定何时更换它们。吸引我的首先是这种控制权,而不是认定本地天然比云端聪明。
隐私数据保护也是一个重要考量。如果推理和资料处理都在本地完成,敏感内容就不必随推理请求发送给云服务。已有工具支持这样的离线工作方式。但我仍要检查远程工具、日志上传和云同步是否让数据外流,并管理本地访问权限;模型在本地,不等于整条数据链路就自动安全。LM Studio 离线说明、Hugging Face 离线与遥测控制
前提仍然是足够好用。如果一套模型与硬件组合能够可靠完成我的核心任务,速度、上下文容量和工具能力也满足需要,那么保留它可能比每次追逐最高分更有意义。稳定地保留一种不够用的能力,并不能解决工作问题。
我也不能指望换一个部署地点,就消除已有模型的污染、错误或纠错问题。固定权重不等于固定每次输出,采样、运行环境和外部工具仍会带来变化;量化与配置更新也需要重新验证。本地更直接改变的是谁能控制变化,也意味着我要承担维护责任。
算成本时,我会把硬件折旧、电力、维护、等待和返工一起算进去,而不只看是否还要逐次支付 token 费用。已有设备、实际使用量和云端订阅是否够用,都会改变结果。对我而言,“更可控”和“更便宜”是两笔需要分别算的账。
我会考虑让本地或低成本模型承担已经验证能胜任的任务,把困难任务交给更强的云服务。但多保留一条路径也有路由、复核和维护开销,只有减少的风险和返工值得这些投入时,这种组合才有意义。
从选择模型到选择可持续的能力
回到最初的感受,我不想把所有失望都归结为“模型被降智了”,也不想用“你没有正确使用它”来消解真实的质量回归。
发布时的高分回答的是特定条件下能做到什么。真正把它放进自己的工作后,我还需要知道:它能否处理我的任务,表现变化能否被发现,错误能否被纠正,以及失效后是否还有退路。
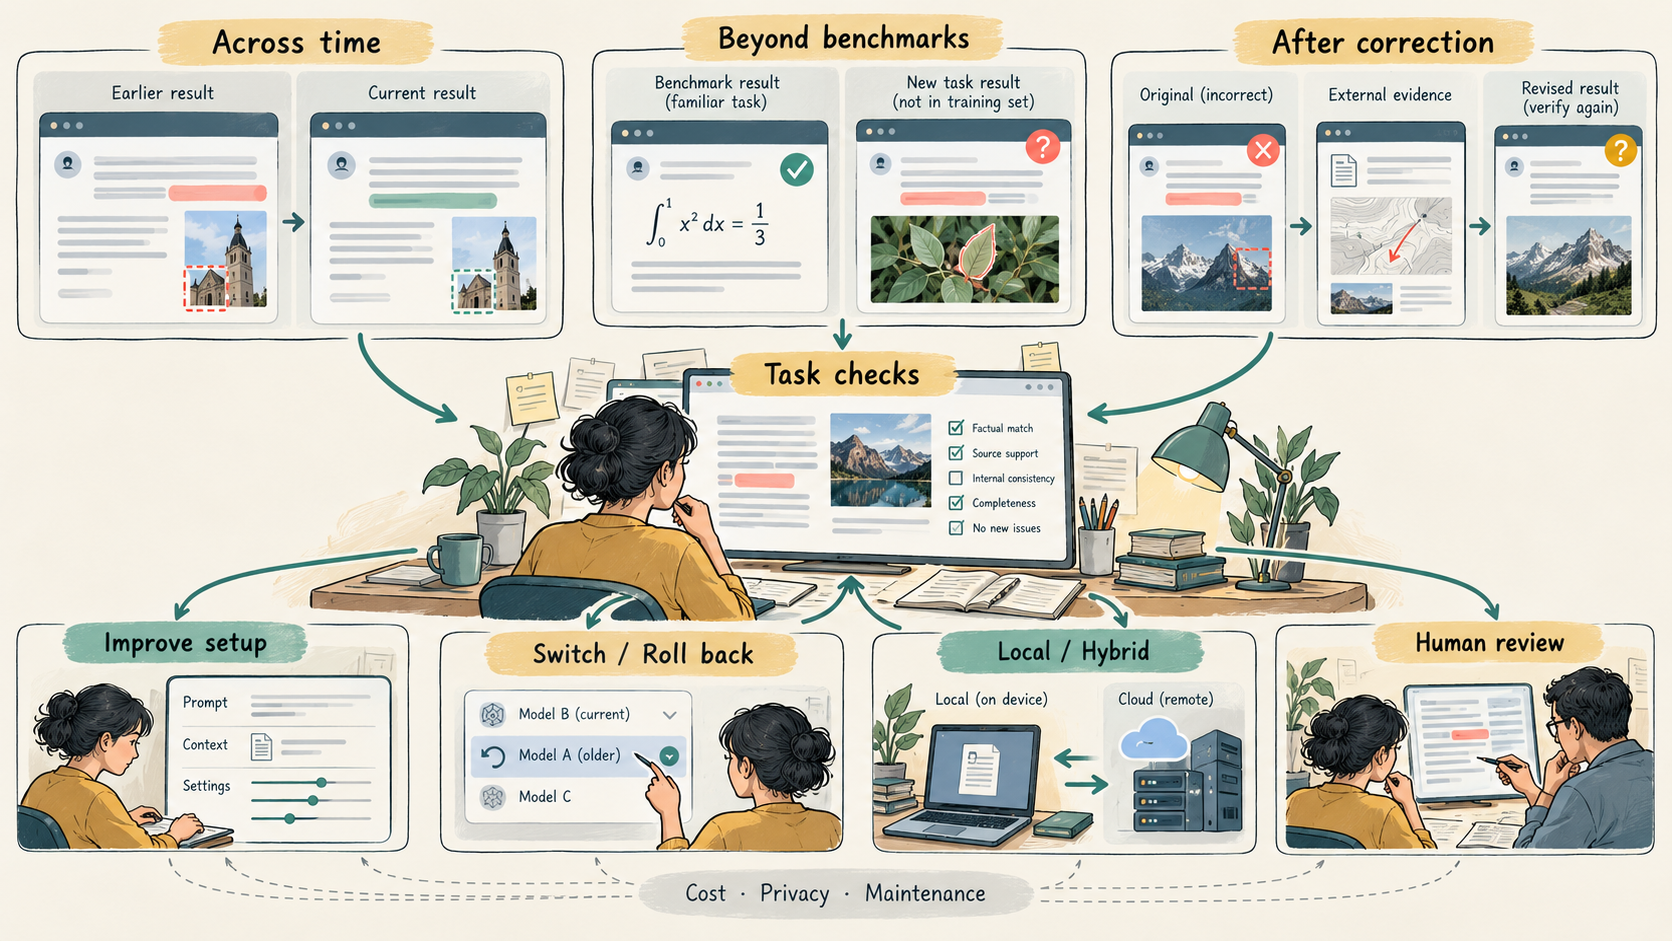
图 1:围绕真实任务检验,选择改进现有方式、替换或回退、本地/混合资源,以及人工复核或接手;每条路径都需重新验收,并权衡成本、隐私与维护。
注:图中“not in training set”具体指未用于我自身提示词调优的任务,并非已知未进入模型训练数据的任务。
因此,我更愿意把个人 AI 看成一套需要持续维护的工作能力,而不是对某个模型的长期押注。云端可以提供难以自行部署的能力,本地可以提供更直接的版本控制;两者都需要经过真实任务的检验。
我最终想保留的,不只是一个曾经很聪明的模型名字,而是一套经过自己验证、知道边界,并且能够恢复或替换的工作方式。
参考资料
- Anthropic. A postmortem of three recent issues. 2025-09-17.
- Margin Lab. Claude Code degraded for the week before Opus 4.8's release. 2026-05-29.
- Chen, L., Zaharia, M., & Zou, J. How Is ChatGPT's Behavior Changing over Time?. arXiv:2307.09009,v3,2023-10-31.
- Yang, S., et al. Rethinking Benchmark and Contamination for Language Models with Rephrased Samples. arXiv:2311.04850,v2,2023-11-11.
- Dunlap, J. C., Parent, A.-S., & Widenhorn, R. Feedback indices to evaluate LLM responses to rebuttals for multiple choice type questions. Discover Artificial Intelligence,2026-06-23.
- Anthropic. Demystifying evals for AI agents. 2026-01-09.
- Google. Gemini API Models,Model version name patterns。查阅于 2026-10-26。
- AWS. Continuous deployment,MLOps checklist。查阅于 2026-10-26。
- Dekoninck, J., Müller, M. N., & Vechev, M. ConStat: Performance-Based Contamination Detection in Large Language Models. NeurIPS 2024.
- Sharma, M., et al. Towards Understanding Sycophancy in Language Models. arXiv:2310.13548,首次提交 2023-10-20,所用 v4 修订于 2025-05-10。
- Google Cloud. Gen AI evaluation service overview. 查阅于 2026-10-26。
- LM Studio. Offline Operation. 查阅于 2026-10-26。
- Hugging Face. Environment variables,HF_HUB_OFFLINE、HF_HUB_DISABLE_TELEMETRY。查阅于 2026-10-26。
AI 协助说明
本文的选题、使用感受与主要问题由我提出,AI 工具参与了资料检索、结构讨论、初稿撰写、引用核对、编辑与配图生成。文中的观点和最终内容由我负责。两张插图由 AI 生成,并由我选用。
Comments
Join the discussionNo comments yet. Be the first to comment.